사진과 음성으로 말하고 노래하는 장면 만들기
인물 이미지와 오디오를 함께 입력해 발화·노래에 반응하는 영상을 생성하는 S2V 예제. 연장 서브그래프로 구간을 이어 붙여요.
Wan2.2 S2V 14B · 음성 기반 영상 by Comfy-Org · 공식 템플릿
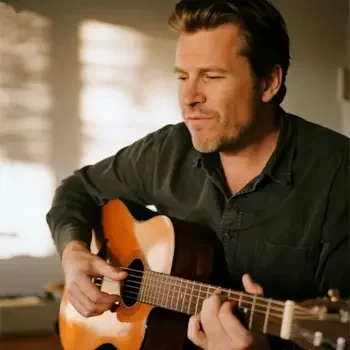 공식 예제
어떤 작업에 쓰나요?
캐릭터의 대사 시안이나 노래 장면을 만들 때 활용합니다. 소리 없는 I2V와 달리 입력 오디오를 생성 조건으로 사용하며 표정과 몸짓은 프롬프트로 보완합니다.
음성 합성이나 번역 기능이 아니라 준비한 음원을 바탕으로 영상을 만드는 구성입니다. 입 모양·소리 싱크와 구간 경계가 어긋날 수 있고 언어·발음에 따라 결과가 달라집니다.
시작 전 준비물
ComfyUI와 아래 모델·노드를 준비하세요. 파일 이름은 설치한 버전에 맞게 선택해야 합니다.
| 모델 / 파일 | 위치 / 확인할 내용 |
|---|---|
wan2.2_s2v_14B_fp8_scaled.safetensors | models/diffusion_models/ |
wav2vec2_large_english_fp16.safetensors | models/audio_encoders/ |
umt5_xxl_fp8_e4m3fn_scaled.safetensors | models/text_encoders/ |
wan_2.1_vae.safetensors | models/vae/ |
wan2.2_t2v_lightx2v_4steps_lora_v1.1_high_noise.safetensors | models/loras/ · 가속 경로 선택 시 |
필요한 기본 노드·서브그래프 지원 여부를 확인하세요. Nightly와 Stable·Desktop의 지원 시점이 다를 수 있습니다.
원본 JSON의 안내 노트에 모델과 입력 예제 링크가 포함되어 있습니다.
사용 순서
S2V 모델과 음원을 준비하세요
I2V 모델 대신 S2V 전용 파일을 선택합니다. 얼굴이 잘 보이는 이미지와 발음이 선명한 짧은 음원을 각각 입력하세요.
실행할 경로 하나를 고르세요
4스텝 LoRA 경로와 일반 경로 중 하나를 활성화합니다. 원본은 가속 LoRA의 일부 키 불일치와 품질 저하 가능성을 설명하므로 일반 경로와 비교할 수 있어요.
연장 수와 배치를 맞추세요
Video S2V Extend를 추가할 때 배치 수를 기본 구간과 연장 구간의 합으로 맞춥니다. 출력에서 입 모양·오디오 싱크·구간 이음새를 검수하세요.
먼저 조절할 값
- 구간 길이
- 원본 안내는 chunk length 77을 기본으로 두고 최소 73프레임을 요구합니다. 무작정 길이를 늘리면 메모리 부담이 커집니다.
- 일반·가속 설정
- 원본 안내 표는 일반 20 steps·CFG 6, 가속 4 steps·CFG 1입니다. 일부 내부 노드에 별도 값이 있어 실제 연결된 상위 입력을 확인하세요.
원작자: Comfy-Org · 공식 템플릿 · 공개 자료 확인: 2026.11.01
원본 자료와 안내를 확인했으며, LABS에서의 GPU 실행·결과 품질 검증은 아직 진행하지 않았습니다. 원본 버전이 바뀌면 화면·설정이 달라질 수 있습니다. 이용 조건은 원작자와 각 모델의 라이선스를 확인하세요.